Traducir subtítulos con IA sin salir de casa: llm-subs + Ollama
Traducir subtítulos línea a línea tiene un problema: pierdes el contexto. Los nombres propios se traducen de forma inconsistente, el género de los personajes se confunde y el tono (formal, coloquial, irónico) se aplana. Herramientas como Google Translate o DeepL hacen lo que pueden, pero no saben que el personaje A es la madre del personaje B, ni que en el episodio anterior se usó "señor" en lugar de "don".
Para un capítulo suelto puede dar igual, pero para una serie es un desastre. Y yo, que tengo el NAS lleno de series con subtítulos en diferentes idiomas, lo he sufrido en mis carnes.
Hace poco encontré llm-subs, una herramienta de línea de comandos que traduce subtítulos usando un LLM, pero con una diferencia clave: tiene memoria por serie. Recuerda nombres, géneros, relaciones y glosario entre episodios. Y lo mejor de todo: puedes usarlo con Ollama en local, sin enviar ni una línea de texto a la nube.
Qué es llm-subs
llm-subs es una herramienta en Python que traduce subtítulos (.srt, .ass, o la pista incrustada en un .mkv) usando un modelo de lenguaje. A diferencia de otras herramientas, no traduce línea a línea: extrae el texto, lo numera, y le pasa al modelo el contexto de las líneas anteriores y posteriores.
Lo interesante:
- No manda el archivo crudo al LLM: solo el texto visible, con IDs estables. Luego reconstruye el
.assrespetando posiciones, colores y estilos. - Memoria por serie: con
--project, el comandoanalyzeextrae personajes, géneros y glosario, ytranslatelo usa. - Múltiples backends:
claude,codex,ollama,litellm... Tú eliges. - Resumible: si se corta a mitad, al relanzar continúa desde el último bloque traducido.
Instalación
Necesitas Python ≥3.11, uv y ffmpeg. En openSUSE Tumbleweed:
sudo zypper install ffmpeg uv
Instala llm-subs como comando global:
uv tool install "git+https://github.com/azratul/llm-subs"
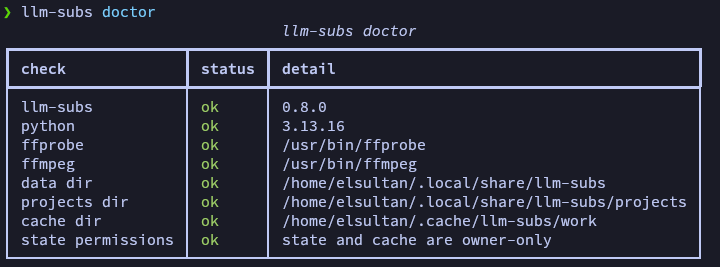
Comprueba que todo está en orden:
llm-subs doctor

Configurar Ollama (local y privado)
Para no enviar el texto a ningún sitio, uso Ollama. Descarga un modelo pequeño (Qwen 3 4B es el que recomienda el README y va bien para traducir):
ollama pull qwen3:4b
Verifica que llm-subs ve el modelo:
llm-subs doctor --provider ollama --model qwen3:4b
Traducir un episodio suelto
Primero, si el subtítulo está dentro de un .mkv, lista las pistas para saber cuál usar:
llm-subs probe "Episodio 01.mkv"
Luego traduce:
llm-subs translate "Episodio 01.mkv" --provider ollama --model qwen3:4b --lang en --target es --non-interactive
El resultado se escribe al lado del original, como Episodio 01.es.ass. Si tu reproductor no soporta .ass, añade --format srt.
El punto fuerte: memoria por serie
Para una serie, no traduzcas episodio a episodio sin más. Usa --project para que llm-subs recuerde el contexto entre capítulos.
El flujo manual:
# Analizar el episodio (extrae personajes, género, glosario)
llm-subs analyze "S01E01.mkv" --provider ollama --model qwen3:4b --project "MiSerie" --target es --lang en --non-interactive

# Traducir usando la memoria acumulada
llm-subs translate "S01E01.mkv" --provider ollama --model qwen3:4b --project "MiSerie" --target es --lang en --non-interactive
Para el resto de episodios, repite analyze → translate manteniendo el mismo --project.
Truco de rendimiento: puedes usar un modelo más potente (o claude en remoto) solo para analyze (que se ejecuta una vez por episodio) y dejar ollama local para translate (que hace muchas más llamadas). O directamente usar ollama para todo si te da igual esperar un poco más.
Si quieres hacer una temporada entera de golpe, batch lo automatiza:
llm-subs batch "Temporada 1/" --project "MiSerie" --provider ollama --model qwen3:4b --target es --lang en --pre-analyze
Lo que me gusta y lo que no
Me gusta:
- Privacidad total con Ollama: el texto de los subtítulos no sale de mi máquina. Para mí, esto es innegociable.
- La memoria por serie: es lo que marca la diferencia. Los nombres se mantienen, los tratamientos son consistentes.
- El respeto por el
.ass: posiciones, colores, estilos... todo se reconstruye. No es un.srtplano. - Resumible: si el portátil se suspende a mitad, al volver sigue donde lo dejó.
Lo que no me gusta tanto:
- Los modelos locales pequeños se inventan cosas. Qwen 3 4B va bien, pero a veces cambia el sentido o mete la pata en algún detalle. Para series con mucho diálogo denso, conviene revisar el resultado.
- No soporta subtítulos en imagen (PGS/VobSub de Blu-ray). Necesitas un
.srto.assde texto. Si el.mkvsolo tiene PGS,llm-subslo rechaza. - La primera vez es lenta: el análisis y la traducción de un episodio con Ollama local pueden llevar su tiempo. A partir del segundo episodio, la memoria acelera las cosas.
Si algo falla
ffmpegno encontrado: instálalo conzypper install ffmpeg.llm-subs doctorte lo dirá.- El modelo no existe: comprueba con
ollama listqueqwen3:4bestá descargado. - Se corta a mitad: relanza el mismo comando.
llm-subsreanuda desde el checkpoint sin repetir trabajo.
En resumen: si tienes series y quieres traducir subtítulos sin depender de la nube y sin perder el contexto entre episodios, llm-subs + Ollama es una combinación muy difícil de superar. No es perfecto (los modelos locales tienen sus límites), pero para un uso personal es más que suficiente.
El repo está en github.com/azratul/llm-subs.